 Volcengine ADK
Responses API
Responses API 是火山方舟最新推出的 API 接口,原生支持高效的上下文管理,具备更简洁的输入输出格式。其工具调用方式更加便捷,不仅延续了 Chat API 的易用性,还结合了更强的智能代理能力。
随着大模型技术不断升级,Responses API 为开发各类面向实际行动的应用提供了更灵活的基础,并支持多种工具调用扩展能力,非常适合搭建智能助手、自动化工具等场景。
使用教程
目前仅 veadk-python 版本支持 Responses API,且对 google-adk 版本有特定要求(google-adk>=1.34.0)。请确保您的环境符合要求。
pip install "google-adk>=1.34.0"uv pip install "google-adk>=1.34.0"快速开始
开启 Responses API
只需配置 enable_responses=True 即可。
from veadk import Agent

root_agent = Agent(
    enable_responses=True, # 开启 Responses API
)
多模型容错
Responses API 同样支持通过 model_name 列表配置容错模型。请求失败时会按顺序尝试后续模型,直到成功或所有模型均失败。
root_agent = Agent(
    enable_responses=True,
    model_name=["doubao-seed-1-8-251228", "deepseek-r1-250528"],
)
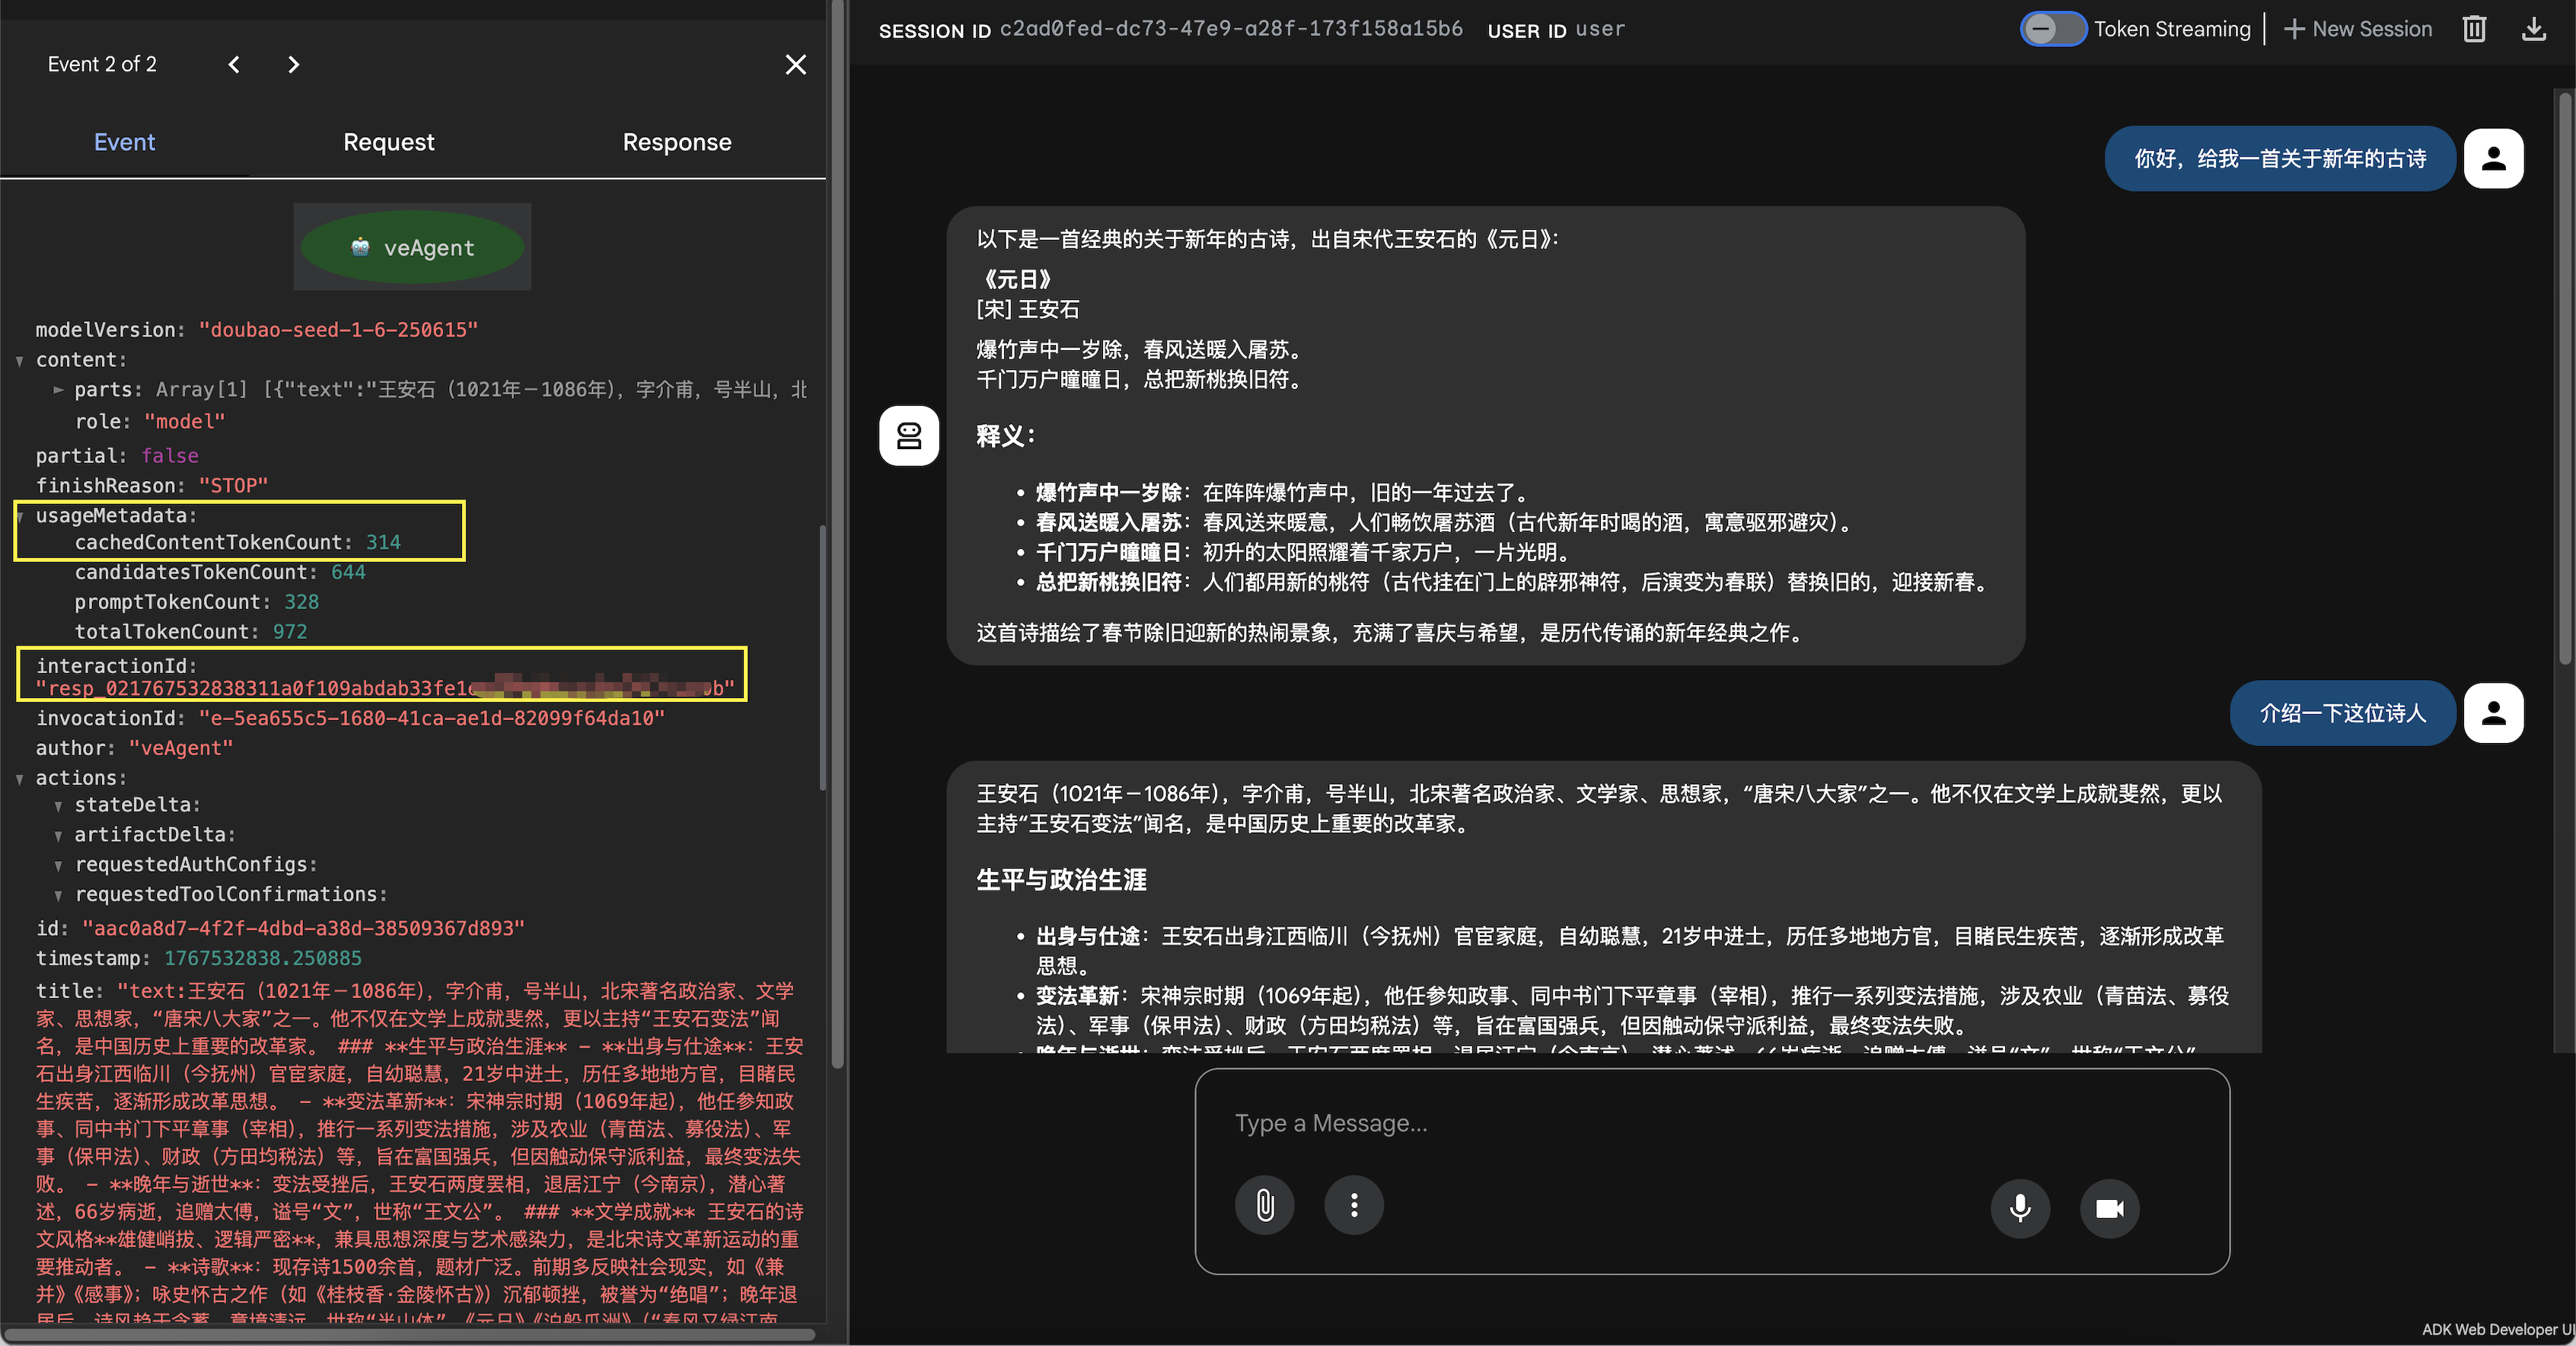
效果展示
多模态能力支持
Responses API 除文本交互外,还具备图片、视频和文件等多模态理解能力。您可以使用 google.genai.types.FileData 字段传递多模态数据(如图片路径、视频 URL、Files API 生成的 file_id 等)。
FileData 支持以下数据传递方式:
-
Files API 资源 (
file_id)- 通过
file_data传递,需在file_uri中添加特定 Scheme 前缀以区分。 - 格式:
file_uri="file_id://xxxxxxx",该值将被自动映射到file_id字段。
- 通过
-
通用资源标识符 (URI) 火山方舟支持的所有文件上传方式(包括
image_url、video_url、file_url)均可通过file_data统一处理。- 网络 URL
- 系统根据
mime_type自动识别资源类型(视频、图片、文件等)。 - 格式:
file_uri="https://..."
- 系统根据
- 本地文件路径
- 直接使用本地文件路径作为
file_uri,底层会自动调用 Files API 完成上传。 - 格式:
file_uri=f"file://{local_path}"
- 直接使用本地文件路径作为
- Base64 Data URI
- 支持传入 Base64 编码的数据。
- 参考:火山方舟:图片理解-Base64 编码
- 网络 URL
样例代码
注:以下所有示例代码均基于下述 Agent 配置与 main 函数:
import os
import asyncio
import uuid

from google.adk.events import Event
from google.genai import types
from google.genai.types import FileData

from veadk import Agent, Runner
from veadk.memory.short_term_memory import ShortTermMemory

agent = Agent(
    enable_responses=True
)
short_term_memory = ShortTermMemory()
runner = Runner(
    agent=agent,
    short_term_memory=short_term_memory,
)

async def main(message: types.Content):
    session_id = uuid.uuid4().hex
    await short_term_memory.session_service.create_session(
        app_name=runner.app_name, user_id=runner.user_id, session_id=session_id
    )

    async for event in runner.run_async(
        user_id=runner.user_id,
        session_id=session_id,
        new_message=message,
    ):
        if isinstance(event, Event) and event.is_final_response():
            if event.content and event.content.parts:
                if not event.content.parts[0].thought:
                    print(event.content.parts[0].text)
                elif len(event.content.parts) > 1:
                    print(event.content.parts[1].text)
图片理解
支持处理最大 512MB 的图片文件。
该方式直接传入本地文件路径,系统会自动调用 Files API 完成上传,随后调用 Responses API 进行分析。
local_path = os.path.abspath("example-data.png")
message = types.UserContent(
    parts=[
        types.Part(text="描述一下这张图片"),
        types.Part(
            file_data=FileData(
                file_uri=f"file://{local_path}",
                mime_type="image/png"
            )
        )
    ],
)
asyncio.run(
    main(message)
)
通过火山方舟 Files API 上传文件,支持处理最大 512MB 的图片文件。
from veadk.utils.misc import upload_to_files_api
local_path = os.path.abspath("example-data.png")
file_id = asyncio.run(upload_to_files_api(local_path))
message = types.UserContent(
    parts=[
        types.Part(text="描述一下这张图片"),
        types.Part(
            file_data=FileData(
                file_uri=f"file_id://{file_id}",
                mime_type="image/png"
            )
        )
    ],
)
asyncio.run(
    main(message)
)支持处理最大 10MB 的图片文件。
image_url = "<your-url>"
message = types.UserContent(
    parts=[
        types.Part(text="描述一下这张图片"),
        types.Part(
            file_data=FileData(
                file_uri=f"{image_url}",
                mime_type="image/png"
            )
        )
    ],
)
asyncio.run(
    main(message)
)
视频理解
通过火山方舟 Files API 上传文件,支持处理最大 512MB 的视频文件。
在 file_data 中传递视频文件时,可选择添加 video_metadata 字段,指定视频的帧率(fps)。
您可以通过 fps 字段,控制从视频中抽取图像的频率,默认为 1,即每秒从视频中抽取一帧图像,输入给模型进行视觉理解。可通过 fps 字段调整抽取频率,以平衡视频长度与模型处理效率。
- 当视频画面变化剧烈或需要关注画面变化,如计算视频中角色动作次数,可以调高 fps 的设置(最高为 5),防止抽帧频率过快导致模型无法准确理解视频内容。
- 当视频画面变化缓慢或不需要关注画面变化,如分析视频中人物行为,可适当降低 fps 的设置(最低为 0.2),以平衡视频长度与模型处理效率。
from veadk.utils.misc import upload_to_files_api
local_path = os.path.abspath("example-video.mp4")
file_id = asyncio.run(upload_to_files_api(local_path, fps=0.3)) # optional `fps`
message = types.UserContent(
    parts=[
        types.Part(text="描述一下这个视频"),
        types.Part(
            file_data=FileData(
                file_uri=f"file_id://{file_id}",
                mime_type="video/mp4"
            ),
            video_metadata={        # optional
                "fps": 0.3
            }
        )
    ],
)
asyncio.run(
    main(message)
)支持处理最大 50MB 的视频文件。
video_url = "<your-video-url>"
message = types.UserContent(
    parts=[
        types.Part(text="描述一下这个视频"),
        types.Part(
            file_data=FileData(
                file_uri=f"{video_url}",
                mime_type="video/mp4"
            )
        )
    ],
)
asyncio.run(
    main(message)
)
文档理解
部分模型支持处理 PDF 格式的文档,系统会通过视觉功能理解整个文档的上下文。当传入 PDF 文档时,大模型会将文件分页处理成多张图片,分析解读其中的文本与图片信息,并结合这些信息完成文档理解任务。
通过火山方舟 Files API 上传文件,支持处理最大 512MB 的文档。
from veadk.utils.misc import upload_to_files_api
local_path = os.path.abspath("example-pdf.pdf")
file_id = asyncio.run(upload_to_files_api(local_path))
message = types.UserContent(
    parts=[
        types.Part(text="请概括总结文档的内容"),
        types.Part(
            file_data=FileData(
                file_uri=f"file_id://{file_id}",
                mime_type="application/pdf"
            )
        )
    ],
)
asyncio.run(
    main(message)
)支持处理最大 50MB 的文档。
message2 = types.UserContent(
    parts=[
        types.Part(text="请总结概括本文档"),
        types.Part(
            file_data=FileData(
                file_uri="<your-file-url>",
                mime_type="application/pdf"
            )
        )
    ],
)
asyncio.run(
    main(message2)
)
上下文缓存
在 Responses API 模式下,VeADK 默认开启会话缓存(Session Caching)。该机制会自动存储初始上下文信息,并在每一轮对话中动态更新。在后续请求中,系统会将缓存内容与新输入合并后发送给模型推理。此功能特别适用于多轮对话、复杂工具调用等长上下文场景。
缓存信息查看
您可以通过返回的 Event.usage_metadata 字段查看 Token 使用及缓存命中情况。
以下是一次包含两轮对话的 usage_metadata 示例:
{"cached_content_token_count":0,"candidates_token_count":87,"prompt_token_count":210,"total_token_count":297}
{"cached_content_token_count":297,"candidates_token_count":181,"prompt_token_count":314,"total_token_count":495}
字段说明:
cached_content_token_count:命中缓存的 Token 数量(即从缓存中读取的 Token 数)。candidates_token_count:模型生成的 Token 数量(输出 Token)。prompt_token_count:输入给模型的总 Token 数量(包含已缓存和未缓存部分)。total_token_count:总消耗 Token 数量(输入 + 输出)。
缓存机制说明:
- 缓存仅影响输入(Prompt)Token,不影响输出(Completion)Token。
- 缓存命中率反映了缓存策略的有效性,命中率越高,Token 成本节省越多。
- 计算公式:
缓存命中率 = (cached_content_token_count / prompt_token_count) × 100%
- 计算公式:
- 输入 Token 成本节约率:用于量化整个会话的缓存收益,是面向业务侧的核心指标,支持会话级汇总计算。
成本节省示例
基于上述样例数据,缓存命中率计算如下:
- 第一轮对话:0%(初始状态,无缓存)
- 第二轮对话:
297 / 314 * 100% ≈ 94.58%
输入 Token 成本节约率:(0 + 297) / (210 + 314) ≈ 56.68%
这意味着在开启缓存后,该次会话的 输入 Token 缓存命中率达到了 56.68%,大幅减少了重复内容的计算开销。火山方舟:缓存 Token 计费说明
注:第 N 轮的 cached_content_token_count 不一定等于第 N-1 轮的 total_token_count,如果开启了 thinking,二者不等。
注意事项
- 版本要求:必须保证
google-adk>=1.34.0。 - 模型支持:请确保使用的模型支持 Responses API(注:Doubao 系列模型 0615 版本之后,除特殊说明外均支持)。
- 缓存机制:VeADK 开启 Responses API 并使用火山方舟模型时默认开启上下文缓存(Session 缓存)。但若在 Agent 中设置了
output_schema,因该字段与缓存机制冲突,系统将自动关闭缓存。