 Volcengine ADK
概述
知识库(KnowledgeBase)是智能体的外部知识来源——一个可随时查阅、专门存放静态资料的"图书馆"。把它挂到智能体上,VeADK 会自动赋予智能体一个检索工具,让它在回答前先到你的资料里检索相关片段,从而给出更精准、更有依据的回答(RAG)。
主要功能
- 知识注入(Ingestion):把外部、非结构化的文本资料(产品文档、FAQ、文章等)添加进知识库,框架自动转换为可检索的格式。
- 从文件导入:
kb.add_from_files([...]) - 从目录导入:
kb.add_from_directory("./docs") - 从内存文本导入:
kb.add_from_text([...])
- 从文件导入:
- 后端抽象(Backend Abstraction):统一接口屏蔽底层向量库差异,初始化时用
backend指定local、viking、opensearch或redis即可,业务代码无需改动。 - 知识检索(Retrieval):把知识库传给智能体后,智能体会自动获得一个内置的
load_knowledgebase工具。回答问题时,它会自主决定是否检索知识库。 - 与 Agent 无缝集成:创建
Agent时传入knowledgebase=kb即可。
使用方法
下面是使用知识库的最小流程。
初始化知识库并注入知识
local 后端无需任何外部服务,最适合上手。它会对文档做向量化,需要安装扩展依赖 pip install "veadk-python[extensions]",并配置 embedding 模型(缺省时复用 MODEL_AGENT_API_KEY)。
from veadk.knowledgebase import KnowledgeBase

kb = KnowledgeBase(backend="local", index="company_faq")

# 从内存文本注入;也可用 add_from_files / add_from_directory
kb.add_from_text(
    [
        "公司的标准年假为每年 15 天,入职满一年起享受。",
        "经主管批准后,员工每周最多可远程办公 2 天。",
    ]
)
集成到 Agent 并运行
import asyncio

from veadk import Agent, Runner

agent = Agent(
    name="kb_agent",
    model_name="doubao-seed-1-8-251228",
    instruction="你是一个知识渊博的助手,请优先利用知识库回答问题。",
    knowledgebase=kb,  # 自动获得 load_knowledgebase 检索工具
)

runner = Runner(agent=agent, app_name="company_faq")

print(asyncio.run(runner.run(messages="年假有多少天?可以远程办公吗?")))
切换到生产用的持久化后端(如 viking、opensearch、redis)时,业务代码几乎不变——只改 backend,并在 config.yaml 里提供对应连接信息。下文介绍这两种后端的开通与配置。
入门示例
资源开通
VikingDB 开通
- 登录控制台进入 VikingDB 操作页面。
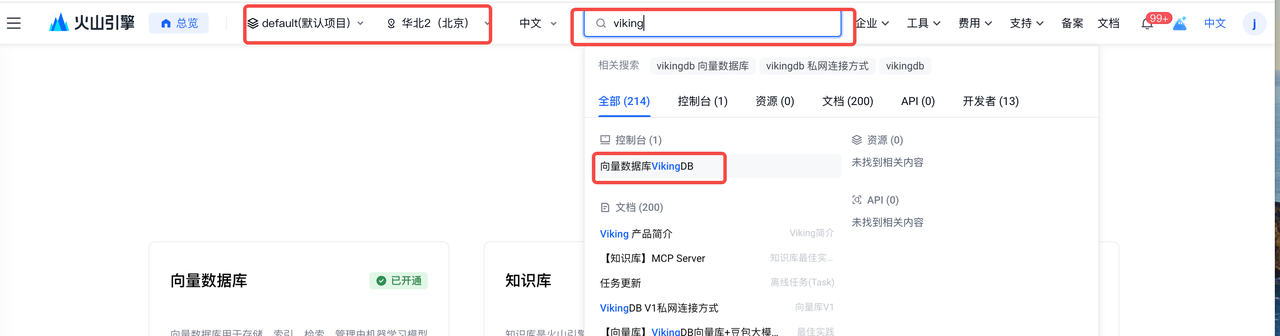
- 进入控制台后,选中中间红框处进入知识库。
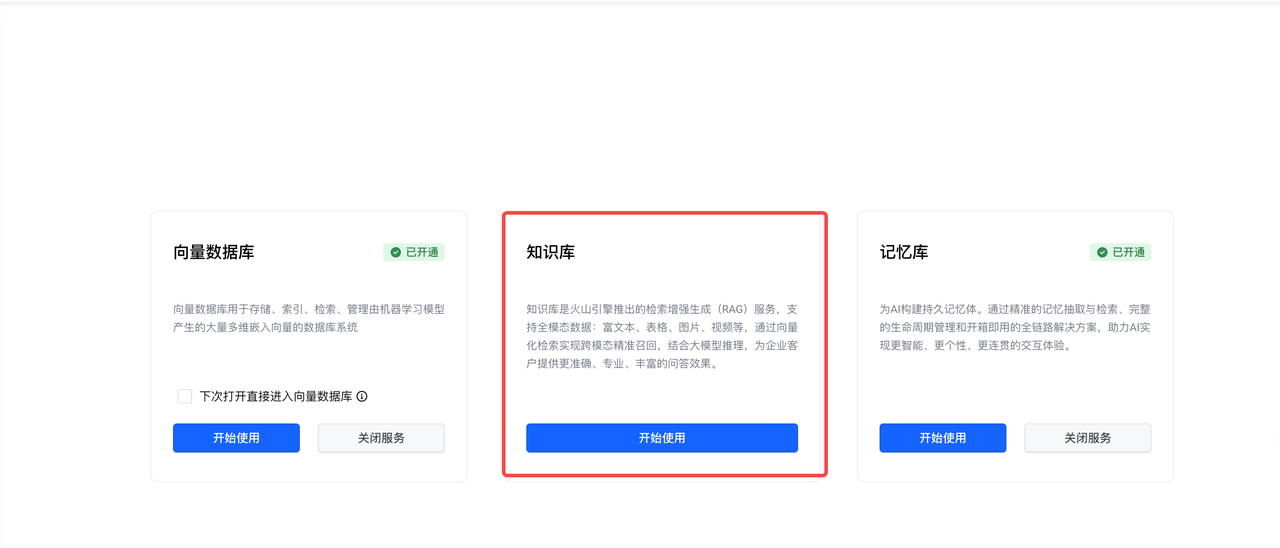
- 进入知识库列表页后,按红框提示进入创建页面。
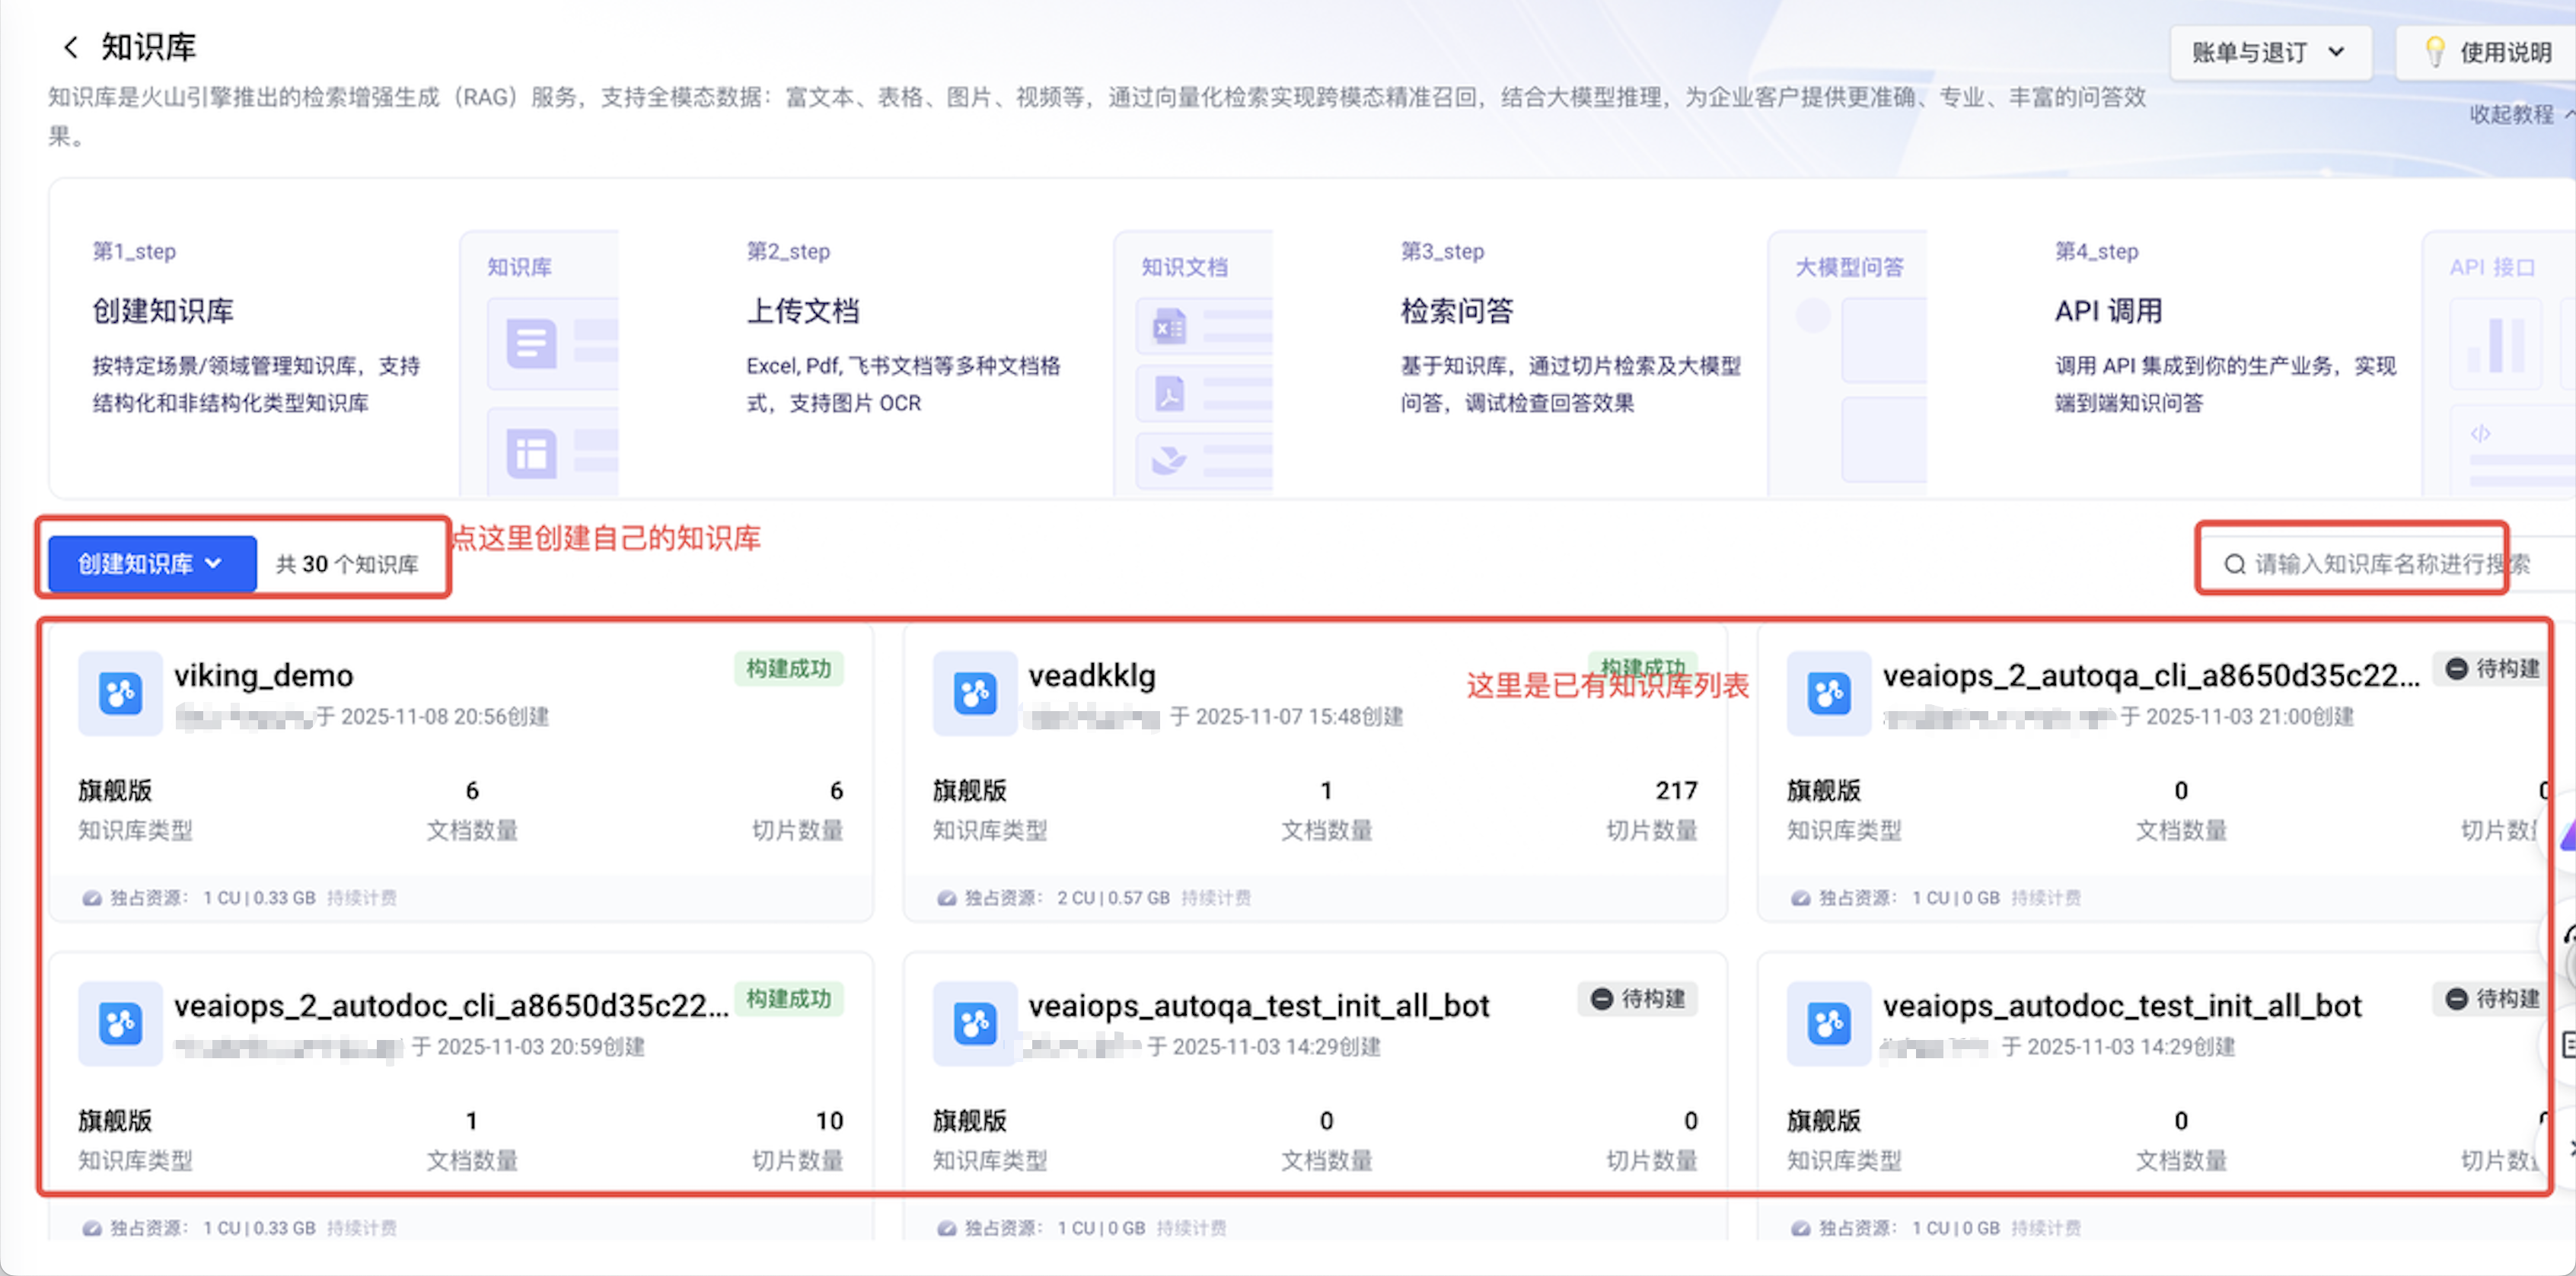
- 点击创建按钮,弹出创建选项(请选择旗舰版本)。
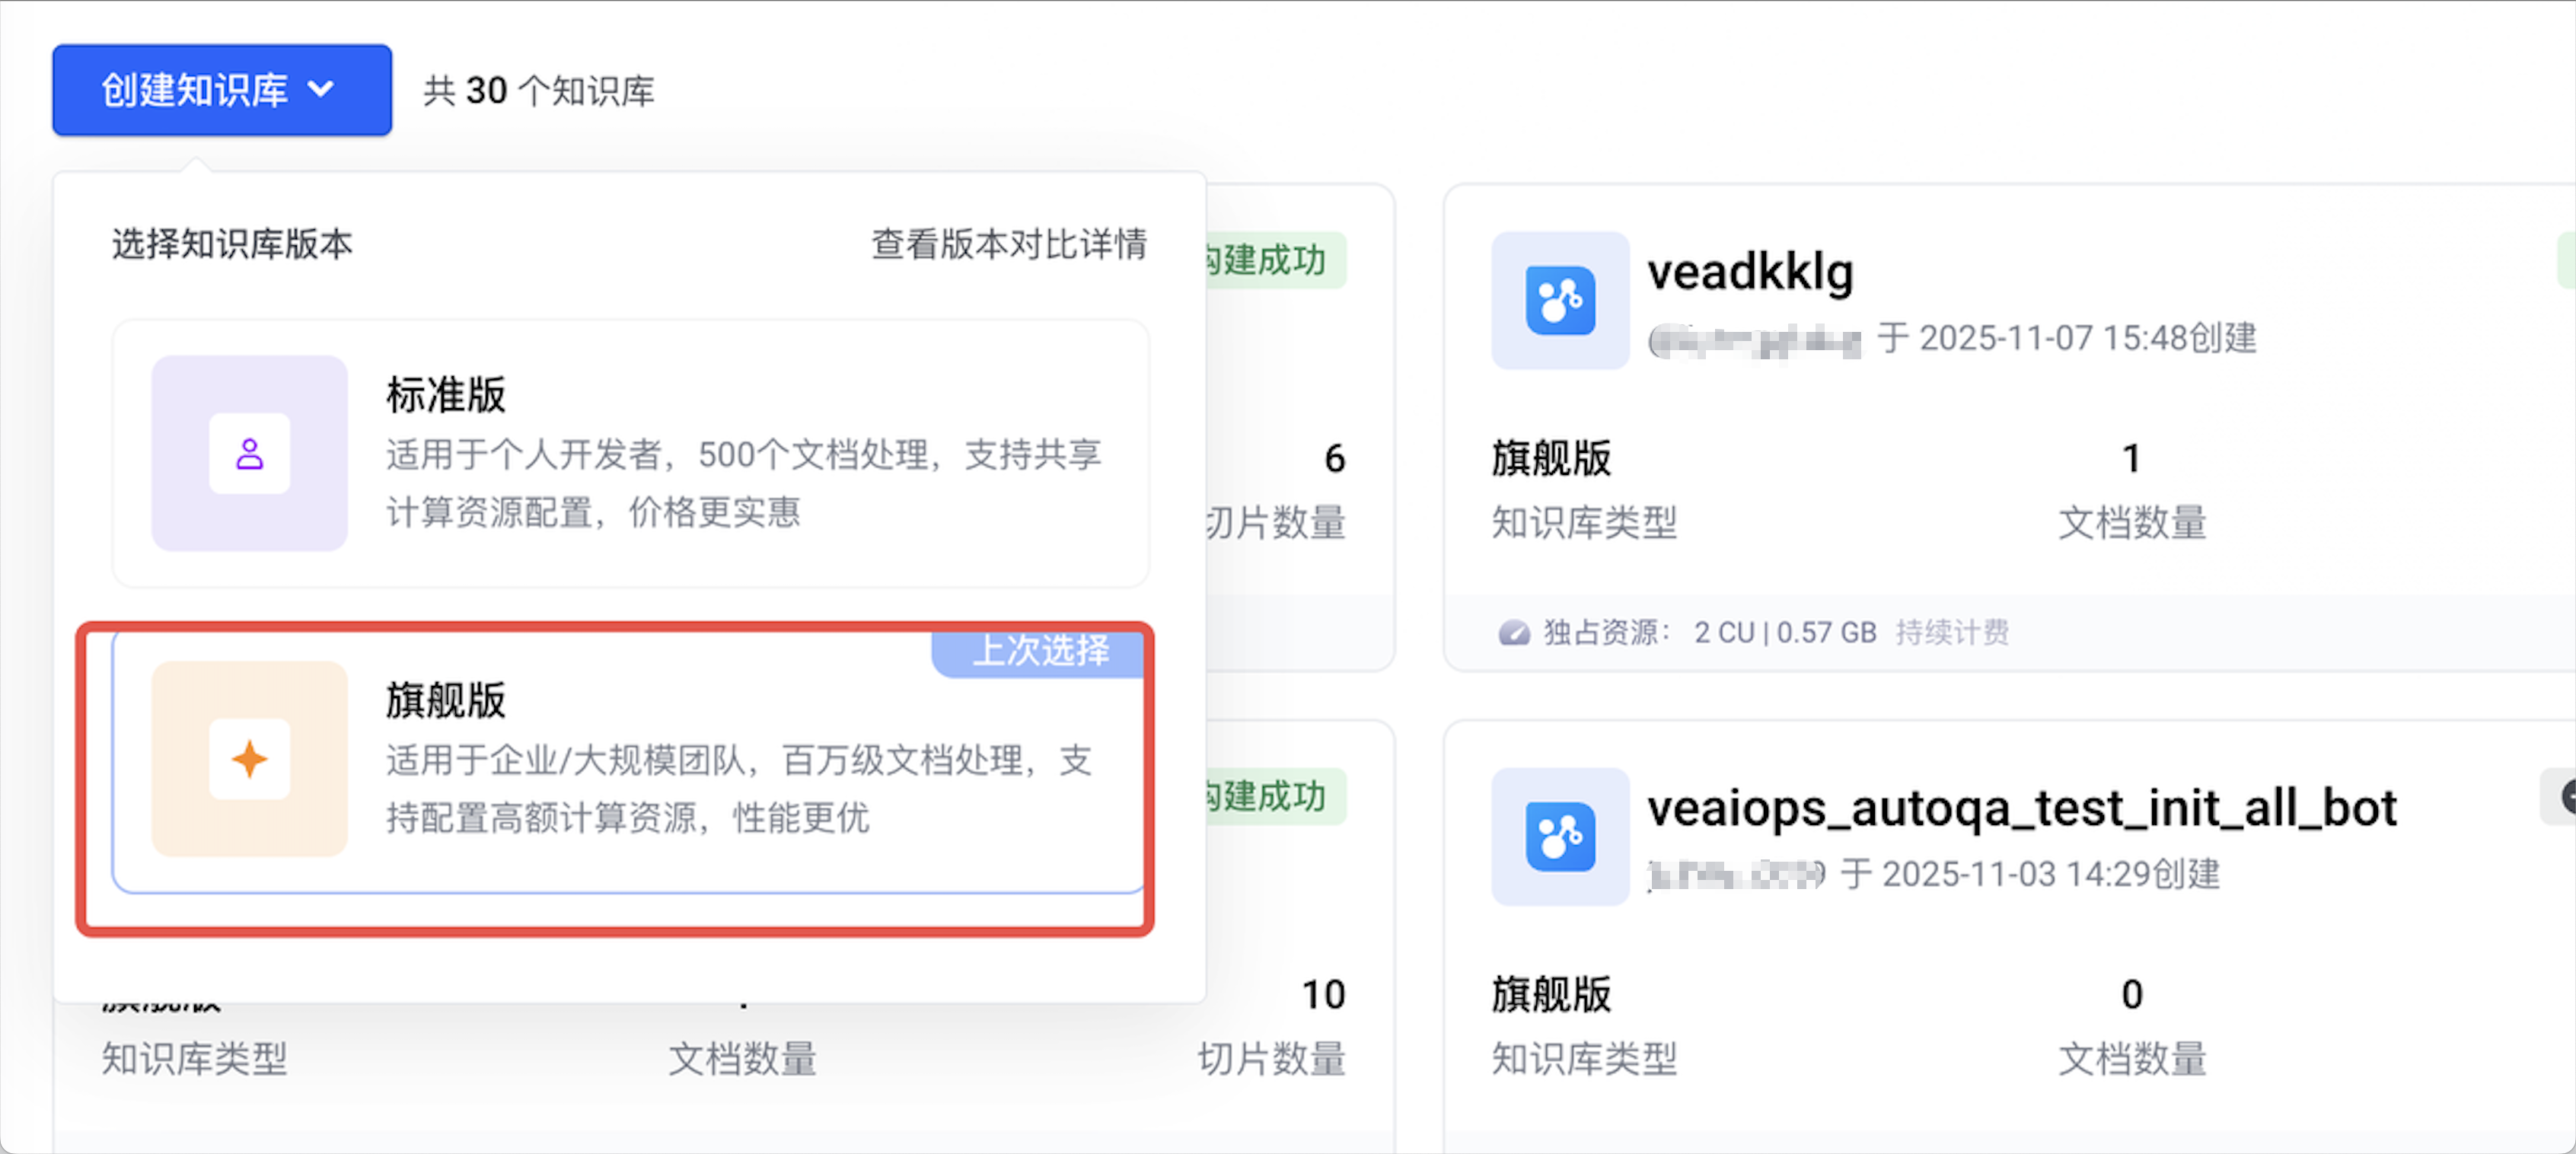
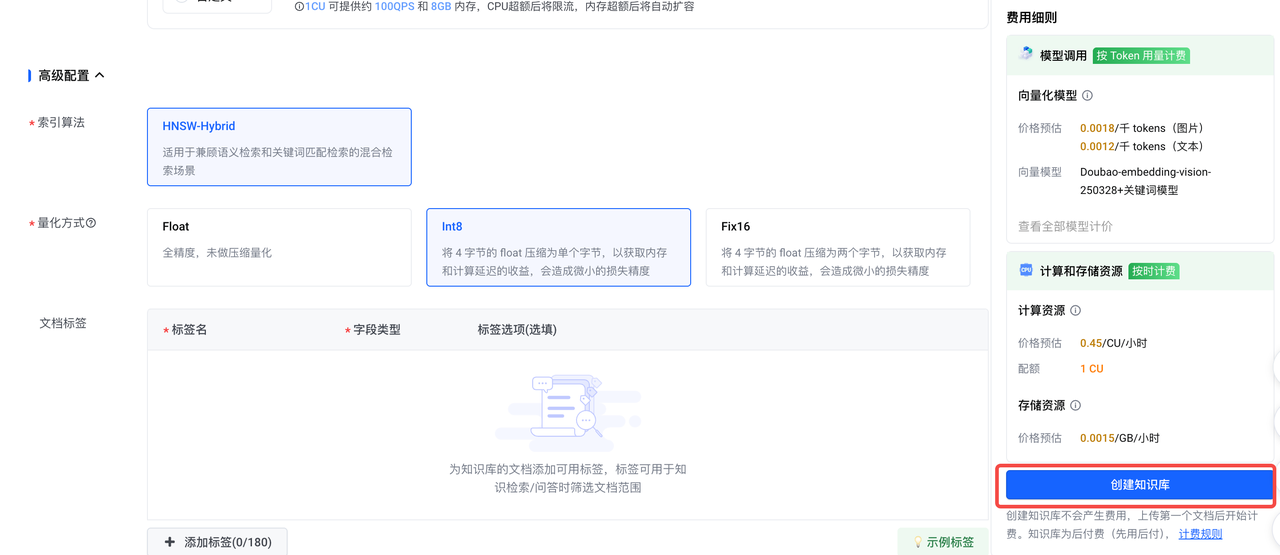
- 进入创建详情页,按提示输入关键信息,核心部分见红框。
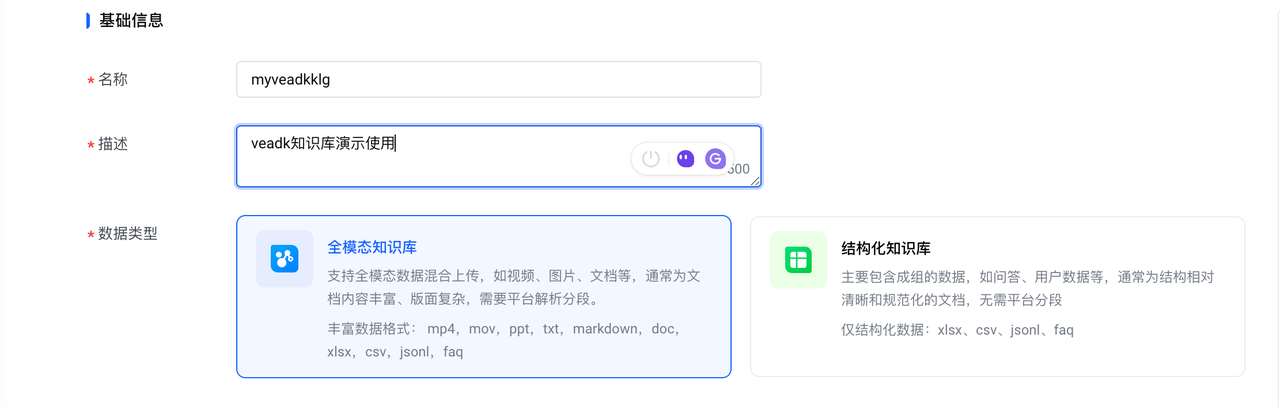
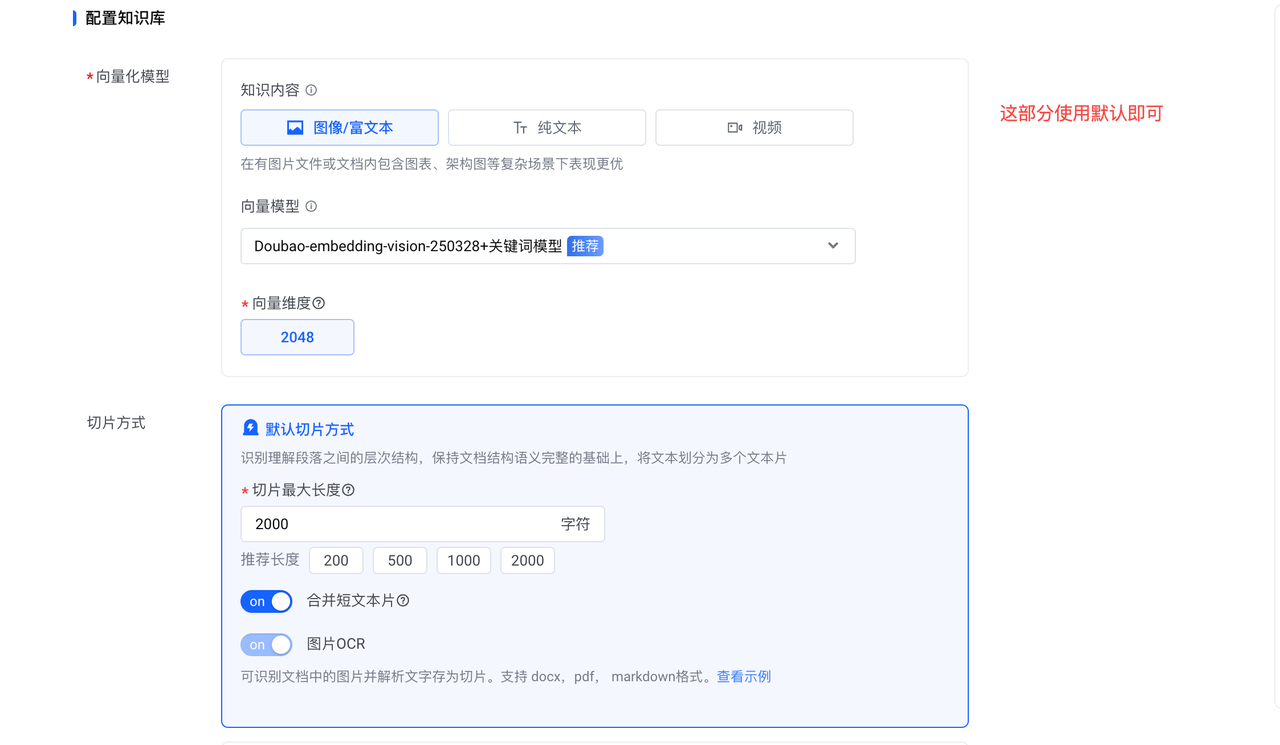
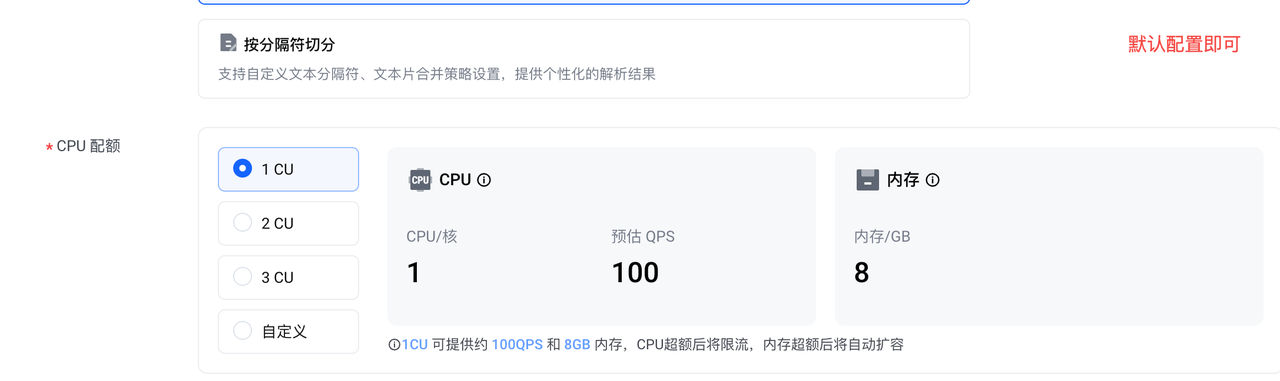
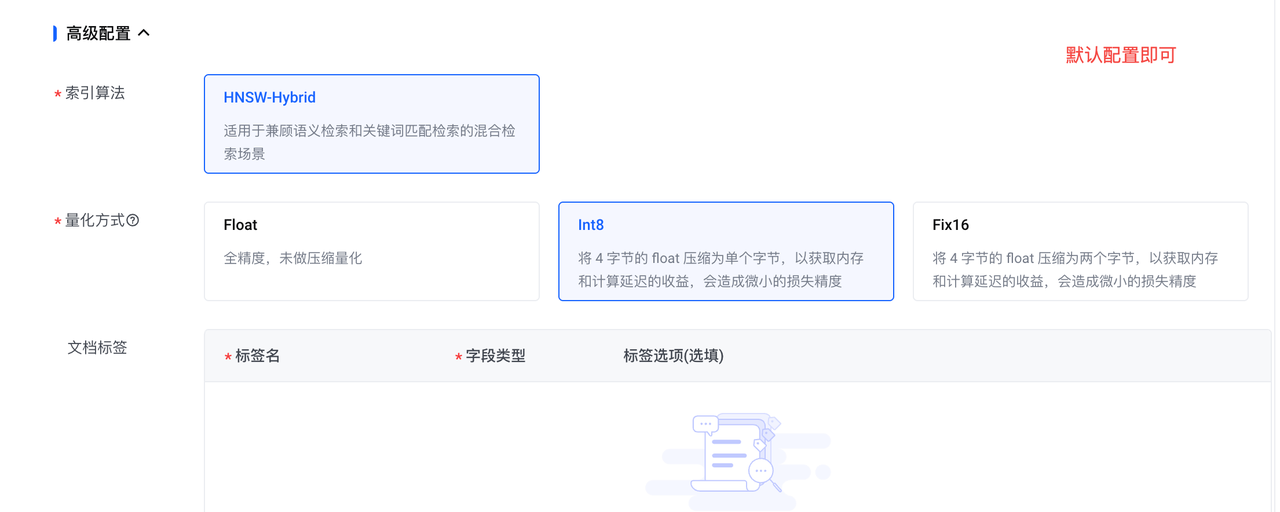
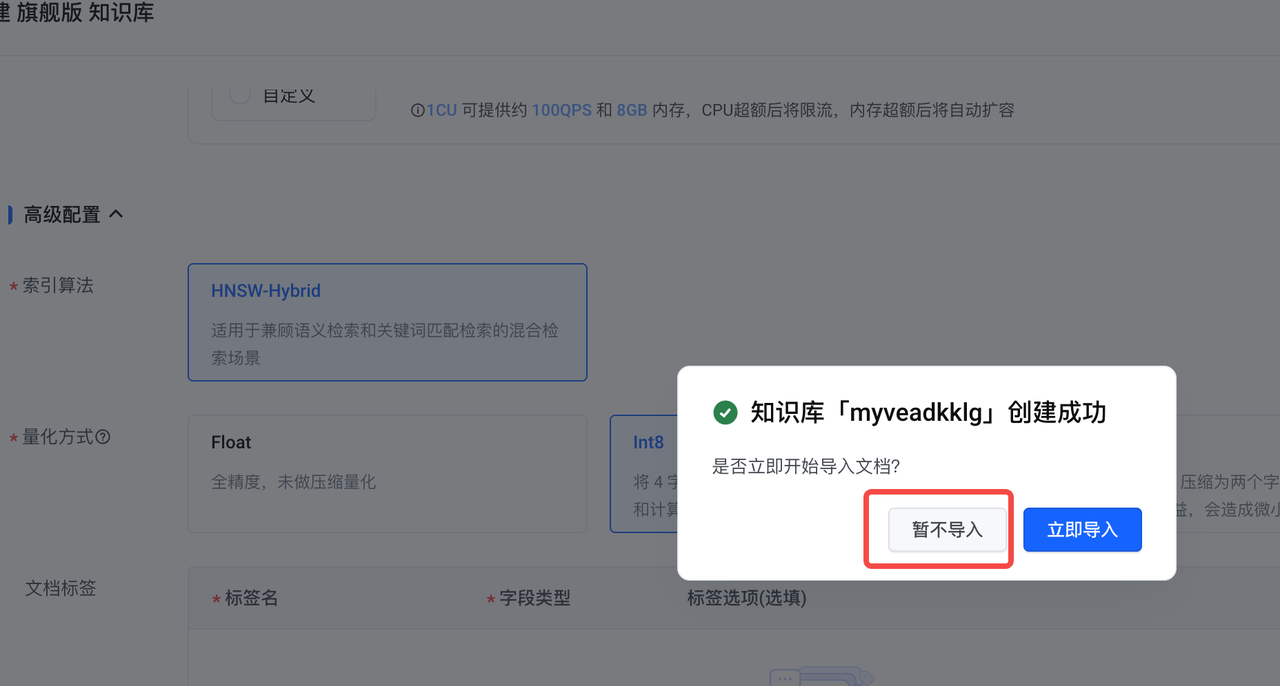
- 点击创建知识库;弹出是否导入文档时,选择暂不导入。
TOS 配置
- 登录火山控制台进入 TOS 控制台,创建 TOS 桶。
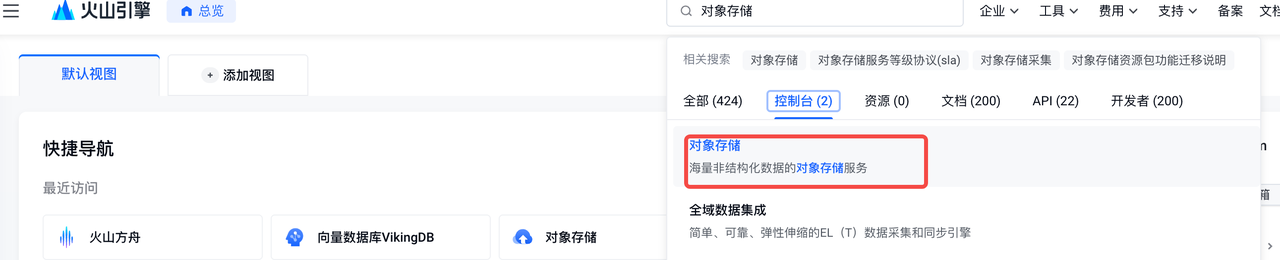
参见 火山引擎 TOS 文档。
OpenSearch 开通
- 登录火山控制台进入云搜索控制台,创建 OpenSearch 实例。
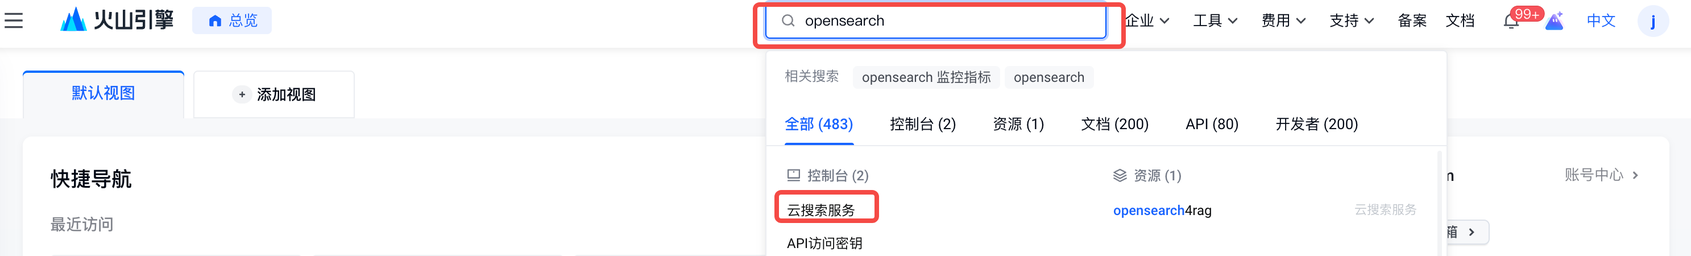
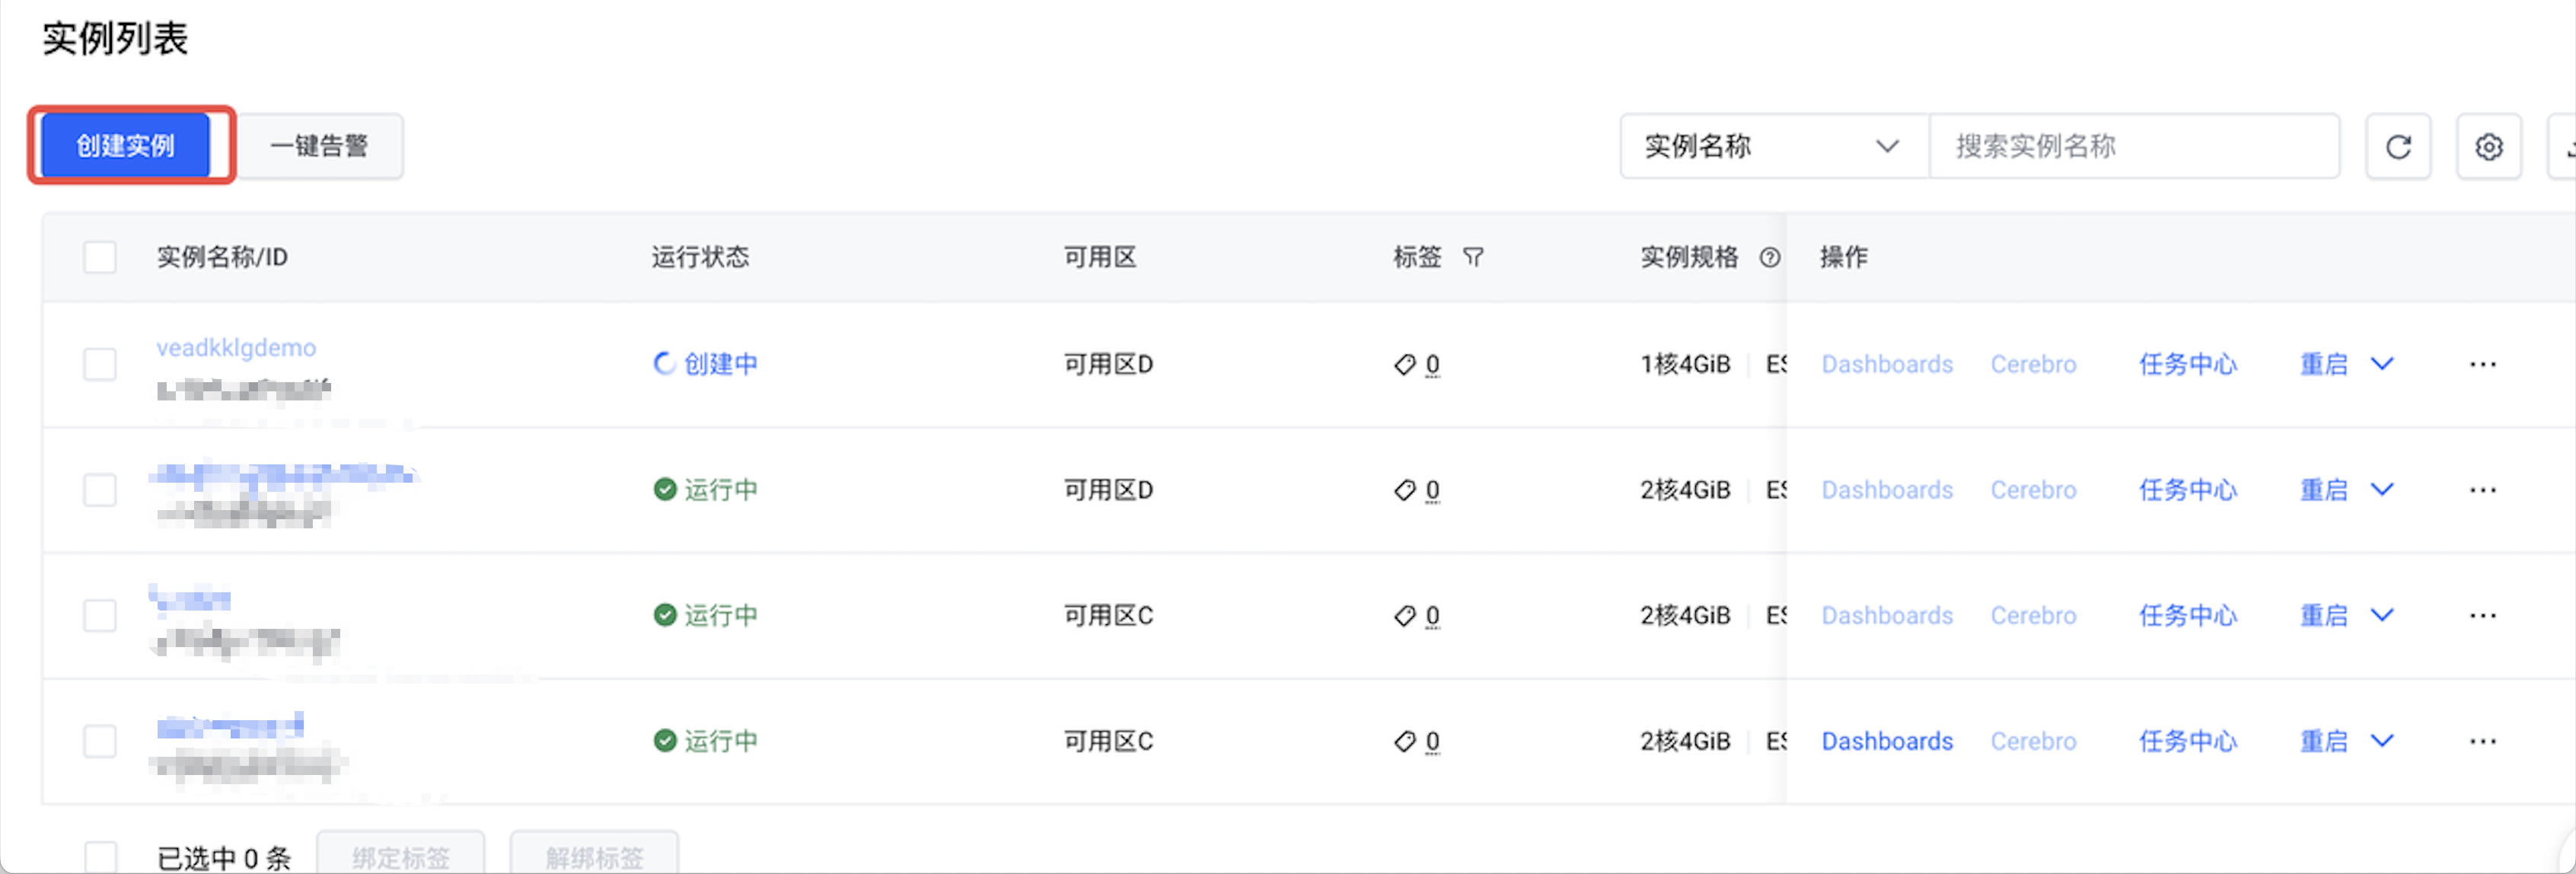
参见 火山引擎云搜索服务文档:创建实例。
代码配置
config.yaml
把上面开通的 VikingDB、TOS、OpenSearch 或 OpenViking 信息填入 config.yaml。密钥不要写进配置文件,用环境变量引用:
model:
  agent:
    provider: openai
    name: doubao-seed-1-8-251228
    api_base: https://ark.cn-beijing.volces.com/api/v3/
    api_key: ${MODEL_AGENT_API_KEY}

volcengine:
  # Viking DB 与 embedding 可使用火山引擎 ak/sk
  access_key: ${VOLCENGINE_ACCESS_KEY}
  secret_key: ${VOLCENGINE_SECRET_KEY}

database:
  viking:
    # 可选;用于搜索已有 VikingDB 知识库
    api_key: ${DATABASE_VIKING_API_KEY}
    project: default    # Volcengine Viking DB 中的项目
    region: cn-beijing
  tos:
    endpoint: tos-cn-beijing.volces.com
    region: cn-beijing
    bucket: your_bucket_name
  opensearch:
    host: your_opensearch_host
    port: 9200
    username: admin
    password: ${DATABASE_OPENSEARCH_PASSWORD}
  openviking:
    url: http://127.0.0.1:1933
    api_key: ${DATABASE_OPENVIKING_API_KEY}
    # user_id 是 config.yaml 中的 OpenViking owner/context ID。
    # 未配置 target_uri 时使用:
    # viking://user/default/resources/{index}/
    # user_id: team_a
    # target_uri: viking://user/team_a/resources/company_faq/
对应地,在环境变量中提供这些密钥:
export MODEL_AGENT_API_KEY="<你的方舟 API Key>"
export DATABASE_VIKING_API_KEY="<你的 VikingDB 知识库 API Key>"
export VOLCENGINE_ACCESS_KEY="<你的 AK>"
export VOLCENGINE_SECRET_KEY="<你的 SK>"
export DATABASE_OPENSEARCH_PASSWORD="<你的 OpenSearch 密码>"
export DATABASE_OPENVIKING_API_KEY="<你的 OpenViking API Key>"
DATABASE_VIKING_API_KEY 会优先用于搜索已有 VikingDB 知识库。创建、删除、列举 collection,管理文档/切片,以及 add_from_text / add_from_files 这类需要上传 TOS 的能力,仍需要可用的 VOLCENGINE_ACCESS_KEY / VOLCENGINE_SECRET_KEY 或 VeFaaS IAM 凭证。
演示场景
下面用一段心理学家简介作为知识,并配一个计算日期差的工具,演示「检索知识库 + 调用工具」。
知识内容:
mock_data = [
    """西格蒙德·弗洛伊德(Sigmund Freud,1856年5月6日-1939年9月23日)是精神分析的创始人。
精神分析既是一种治疗精神疾病的方法,也是一种解释人类行为的理论。""",
    """阿尔弗雷德·阿德勒(Alfred Adler,1870年2月7日-1937年5月28日),奥地利精神病学家,
人本主义心理学先驱,个体心理学的创始人。""",
]
智能体角色设定:
instruction = """你是一个优秀的助手。当被提问时,请遵循以下步骤:
1. 先根据内部知识给出初步回答;
2. 查询知识库,寻找相关信息来验证或丰富答案;
3. 结合内部知识与知识库信息,给出全面、准确的最终答案。"""
测试问题:
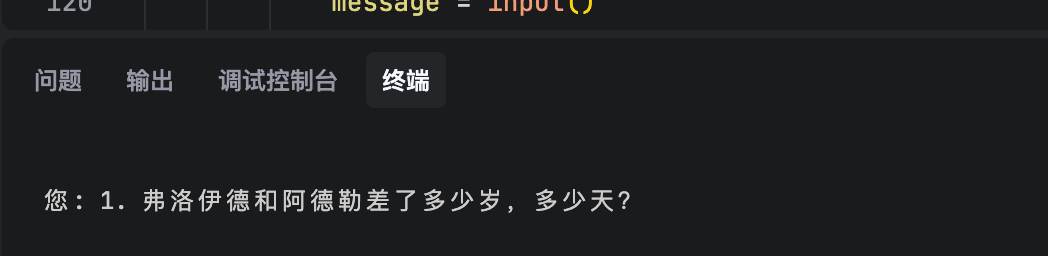
- 弗洛伊德和阿德勒相差多少岁?
- 弗洛伊德和阿德勒相差多少天?他们对后世的影响有多大?
VikingDB 作为存储
VikingDB 需要在使用前显式创建一次集合。下面从内存文本注入知识:
from veadk.knowledgebase import KnowledgeBase

APP_NAME = "viking_demo"

kb = KnowledgeBase(backend="viking", index=APP_NAME)

if not kb.collection_status()["existed"]:
    kb.create_collection()  # Viking 需要显式创建集合

kb.add_from_text(mock_data)
OpenViking 作为存储
OpenViking 后端使用 OpenViking 的资源目录存放知识,不需要本地 embedding 配置。index 仍用于命名资源目录。如果不传 backend_config,VeADK 可以从 KnowledgeBase(index=...) 或 app_name 补齐 index;如果传了 backend_config,请在该字典内显式提供 index。未显式配置 target_uri 时,默认目录为:
viking://user/{openviking_user_id or default}/resources/{index}/其中 openviking_user_id 来自 backend_config["openviking_user_id"] 或 DATABASE_OPENVIKING_USER_ID,都未配置时使用 default。旧的 backend_config["user_id"] 仍作为兼容 alias 可用。如果传入 target_uri 或 DATABASE_OPENVIKING_TARGET_URI,则直接使用该目录。
from veadk.knowledgebase import KnowledgeBase

kb = KnowledgeBase(
    backend="openviking",
    app_name="company_faq",
    backend_config={
        "index": "company_faq",
        "url": "http://127.0.0.1:1933",
        "api_key": "your-openviking-api-key",
        # 可选;不传时默认 default
        "openviking_user_id": "team_a",
        # 可选;不传时默认 viking://user/team_a/resources/company_faq/
        # "target_uri": "viking://user/team_a/resources/company_faq/",
    },
)

kb.add_from_directory("./docs")
results = kb.search("远程办公政策是什么?")
完整可运行示例(VikingDB 后端,配合一个日期差工具):
import asyncio
from datetime import datetime

from veadk import Agent, Runner
from veadk.knowledgebase import KnowledgeBase

APP_NAME = "viking_demo"

mock_data = [
    "西格蒙德·弗洛伊德(1856年5月6日-1939年9月23日)是精神分析的创始人。",
    "阿尔弗雷德·阿德勒(1870年2月7日-1937年5月28日)是个体心理学的创始人。",
]

kb = KnowledgeBase(backend="viking", index=APP_NAME)
if not kb.collection_status()["existed"]:
    kb.create_collection()
kb.add_from_text(mock_data)


def calculate_date_difference(date1: str, date2: str) -> int:
    """计算两个日期之间的天数差(绝对值)。

    Args:
        date1: 第一个日期,格式 "YYYY-MM-DD"。
        date2: 第二个日期,格式 "YYYY-MM-DD"。

    Returns:
        两个日期之间的天数差。
    """
    d1 = datetime.strptime(date1, "%Y-%m-%d")
    d2 = datetime.strptime(date2, "%Y-%m-%d")
    return abs((d2 - d1).days)


agent = Agent(
    name="chat_agent",
    model_name="doubao-seed-1-8-251228",
    instruction=(
        "你是一个优秀的助手。回答时先查询知识库验证或丰富答案,"
        "再结合内部知识给出全面准确的回答。"
    ),
    knowledgebase=kb,
    tools=[calculate_date_difference],
)

runner = Runner(agent=agent, app_name=APP_NAME)

if __name__ == "__main__":
    print(asyncio.run(runner.run(messages="弗洛伊德和阿德勒相差多少天?")))
运行结果
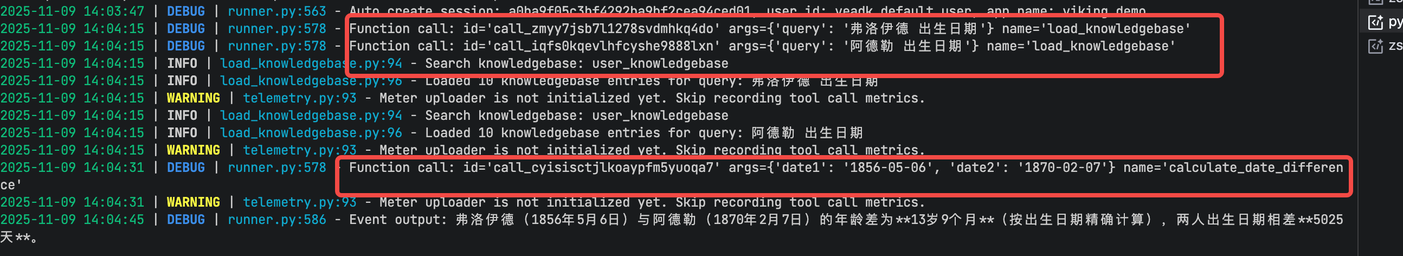
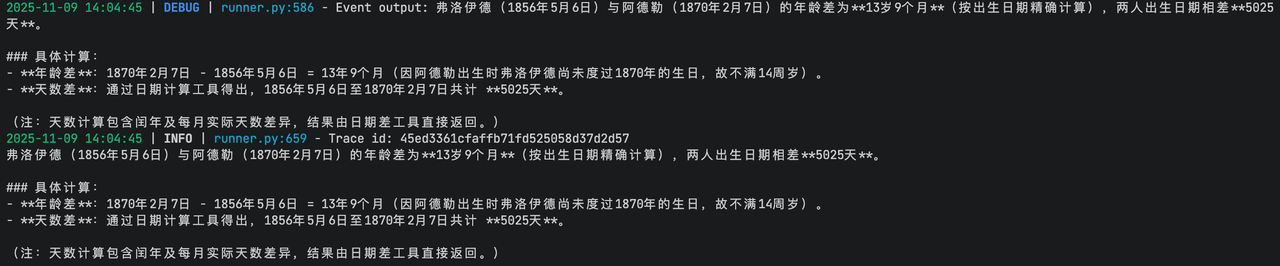
下图展示智能体先通过 load_knowledgebase 检索知识库,再通过 Function Call 调用 calculate_date_difference,最后给出综合回答。
OpenSearch 作为存储
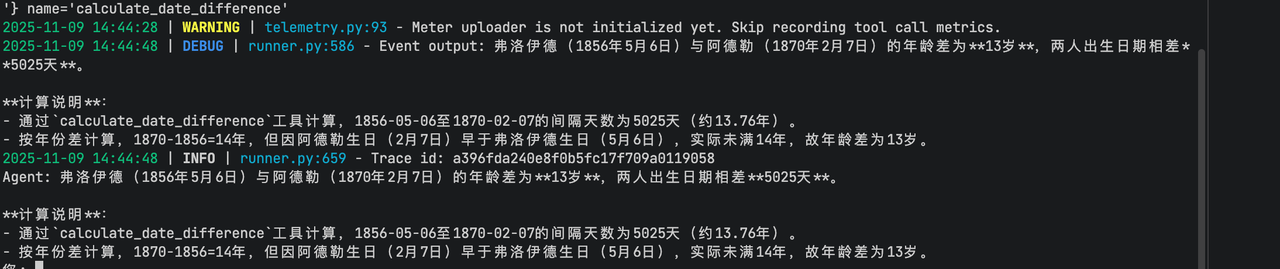
OpenSearch 通常自动创建索引,无需显式 create。下面从文件注入知识,并额外挂载真实的 web_search 工具,在知识库信息不足时联网补充:
import asyncio
from datetime import datetime

from veadk import Agent, Runner
from veadk.knowledgebase import KnowledgeBase
from veadk.tools.builtin_tools.web_search import web_search

APP_NAME = "opensearch_demo"

kb = KnowledgeBase(backend="opensearch", index=APP_NAME)
kb.add_from_files(["tmp/demo.txt"])  # 事先把知识写入 tmp/demo.txt


def calculate_date_difference(date1: str, date2: str) -> int:
    """计算两个日期之间的天数差(绝对值)。

    Args:
        date1: 第一个日期,格式 "YYYY-MM-DD"。
        date2: 第二个日期,格式 "YYYY-MM-DD"。

    Returns:
        两个日期之间的天数差。
    """
    d1 = datetime.strptime(date1, "%Y-%m-%d")
    d2 = datetime.strptime(date2, "%Y-%m-%d")
    return abs((d2 - d1).days)


agent = Agent(
    name="chat_agent",
    model_name="doubao-seed-1-8-251228",
    instruction=(
        "你是一个优秀的助手。回答时先查询知识库;"
        "若知识库信息不足或涉及实时信息,使用 `web_search` 联网搜索;"
        "最后结合各方信息给出全面准确的回答。"
    ),
    knowledgebase=kb,
    tools=[calculate_date_difference, web_search],
)

runner = Runner(agent=agent, app_name=APP_NAME)

if __name__ == "__main__":
    print(asyncio.run(runner.run(messages="弗洛伊德和阿德勒相差多少天?")))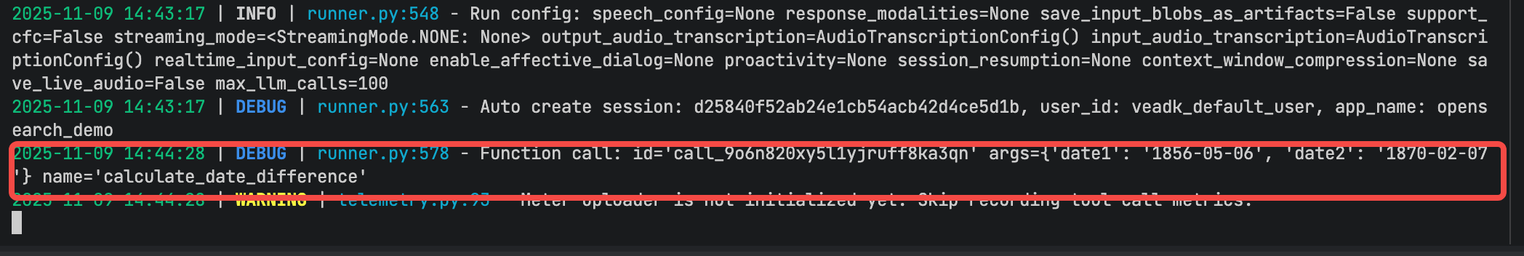
总结与对比
知识库的设计让你可以轻松切换底层向量库,而无需改动大部分业务代码。主要差异在于前期配置,以及 Viking 需要显式创建集合。
| 特性 | Viking 后端 | OpenSearch 后端 |
|---|---|---|
| 核心优势 | 托管服务、免运维,与火山引擎生态结合紧密。 | 开源、灵活,可私有化部署,社区成熟。 |
| config.yaml | 需要 viking.project、viking.region 及 tos。 | 需要 opensearch.host、port、username、password。 |
| 初始化 | 使用前需检查并调用 kb.create_collection()。 | 通常自动创建索引,无需额外步骤。 |
| 代码使用 | 完全一致:add_from_files、add_from_text 等用法相同。 | 完全一致:抽象层屏蔽了差异。 |
| 依赖 | 依赖火山引擎 ak/sk 进行认证与 embedding。 | 同样需要 ak/sk 调用 embedding 模型,但数据库本身独立。 |